
Checklist completo de SEO técnico para 2027. Elementos essenciais para rastreadores humanos e de IA
Eis a verdade incômoda que a maioria dos conteúdos técnicos de SEO tenta evitar para 2027: nenhum dos fundamentos mudou de fato.
Sites rápidos, rastreáveis e bem estruturados eram a base da visibilidade nos mecanismos de busca há uma década, e continuam sendo hoje. O que mudou foi quem os lê, o quão implacável o público se tornou e o preço que se paga por errar.
As próprias diretrizes do Google são inequívocas nesse ponto: SEO técnico é a disciplina que ajuda os mecanismos de busca a encontrar, rastrear, entender e indexar suas páginas.
Uma análise técnica da Ahrefs deixa claro que isso agora vai além da busca tradicional: a busca por IA ainda depende de páginas da web rastreáveis, bem estruturadas e confiáveis.
Um catálogo de produtos renderizado em JavaScript, que o Googlebot passou uma década aprendendo a interpretar, muitas vezes é uma página em branco para os rastreadores que alimentam o ChatGPT, o Claude e o Perplexity. Um site lento e tecnicamente complexo, que antes apenas tinha um desempenho ruim nos rankings, agora pode simplesmente não existir em uma resposta gerada por IA.
Este post pretende ampliar seu conhecimento sobre SEO técnico para 2027 na era da IA e reúne orientações atuais de todo o setor – a própria documentação do Search Central do Google, Ahrefs, Moz, Semrush, Screaming Frog, Search Engine Land, Neil Patel e Bruce Clay – para fornecer uma referência única e priorizada sobre o que realmente importa em 2027 e o que é boato.
Ao final deste post SEO técnico para 2027, você entenderá:
- Por que o SEO técnico se tornou mais importante, e não menos, com o crescimento da busca por IA?
- Fundamentos de rastreabilidade e indexabilidade, incluindo o comportamento real de bots de IA como o GPTBot.
- Qual será o cenário dos Core Web Vitals em 2027 e quais limites ainda serão relevantes?
- Como os dados estruturados geram resultados valiosos e citações em IA.
- Os erros de indexação “mobile-first” e de renderização em JavaScript ainda prejudicam a visibilidade dos sites.
- Listas de verificação específicas para cada plataforma: Shopify, WordPress e sistemas personalizados.
Após ler SEO técnico para 2027, solicite uma avaliação gratuita de nossos Serviços de SEO em Salvador para ver exatamente como seu site se encontra em relação a esta lista de verificação.
Por que o SEO técnico importa mais, e não menos, em um mundo de buscas impulsionado por IA
Existe uma suposição equivocada que circula nos círculos de marketing: a de que, à medida que a busca por IA se expande, as antigas regras técnicas importam menos, porque a IA é “mais inteligente” do que um rastreador tradicional e consegue simplesmente resolver as coisas sozinha.
A verdade é que podemos desmentir completamente essa ideia, e os dados do setor comprovam isso.
A descoberta mais importante das sessões técnicas da conferência, reiterada por diversos palestrantes, reformula completamente o tema: o Google dedicou quase uma década a ensinar o Googlebot a renderizar JavaScript, interpretar conteúdo dinâmico e compreender arquiteturas de página complexas.
O ChatGPT, Claude, Gemini, Perplexity e os rastreadores por trás deles não tiveram essa década. Se o seu site depende de JavaScript para renderizar as palavras, títulos, produtos ou preços relevantes, e esse conteúdo só aparece após a execução de um script no navegador, muitos rastreadores de IA simplesmente não conseguem lê-lo. Do ponto de vista deles, seu conteúdo não existe.
Essa não é uma preocupação isolada. Pesquisas independentes analisadas pelo Search Engine Land confirmam que os sistemas de IA agora operam por meio de famílias de rastreadores distintos, com diferentes propósitos e capacidades técnicas, e muitos sites estão bloqueando inadvertidamente os próprios bots pelos quais desejam obter visibilidade, simplesmente porque seus arquivos robots.txt não foram revisados há anos.
A visão da Moz sobre o funcionamento dos mecanismos de busca é um modelo mental útil para todo este post: tudo passa por uma sequência de rastreamento, indexação e classificação, e se você falhar na primeira etapa, nada mais importa nas etapas seguintes. Isso era verdade quando se aplicava apenas ao Google.
Agora, também é verdade para todas as plataformas de IA que influenciam a primeira impressão que seus clientes têm da sua marca.
A parte reconfortante, e vale a pena guardar essa informação enquanto você lê o resto deste post, é a seguinte: um site tecnicamente impecável, com carregamento rápido, que utiliza dados estruturados corretamente e possui sinais de marca consistentes em toda a web terá um bom desempenho no Google.
Também terá um bom desempenho para os rastreadores de IA. Além disso, terá maior probabilidade de ser citado por plataformas de IA em suas respostas. O público se expandiu. Os fundamentos permanecem. O que mudou foi o custo de ignorá-los.
Fundamentos de Rastreabilidade e Indexabilidade (incluindo bots de IA como o GPTBot)
A capacidade de ser rastreado e a capacidade de ser indexado são duas coisas diferentes, e essa distinção é mais importante do que nunca agora que você está gerenciando o acesso para várias famílias de bots com comportamentos muito diferentes.
A rastreabilidade se refere à capacidade de um robô acessar uma página. A indexabilidade se refere à capacidade de, uma vez acessada, essa página ser armazenada e potencialmente exibida.
Uma página pode ser rastreável, mas não indexável (uma tag noindex, um link canônico incorreto, conteúdo insuficiente que aciona um filtro de qualidade). Uma página também pode falhar completamente na etapa anterior: nenhum link interno apontando para ela, um recurso bloqueado ou uma regra no robots.txt que a exclui silenciosamente.
O cenário dos rastreadores de IA fragmentou-se, e tratá-los como um único bot agora é comprovadamente dispendioso.
O maior erro que vemos rumo a 2027 é as empresas tratarem os “rastreadores de IA” como um grupo indiferenciado, bloqueando-os ou permitindo-os indiscriminadamente sem compreender a distinção. Essa não é mais uma prática aceitável.
Os principais fornecedores de IA dividiram seus rastreadores por função. A OpenAI executa o GPTBot para treinamento de modelos e um bot separado, o OAI-SearchBot, para resultados de busca do ChatGPT em tempo real. A Anthropic executa vários bots distintos para treinamento e recuperação de dados. Google, Amazon e Apple seguem o mesmo padrão.
A OpenAI mantém o OAI-SearchBot especificamente para construir um índice de busca e citação, separadamente do GPTBot, que existe exclusivamente para coletar dados de treinamento.
Na prática: bloquear o GPTBot no seu robots.txt não remove você dos resultados de busca do ChatGPT. Mas se você bloquear acidentalmente o OAI-SearchBot junto com ele, usando uma regra geral de “bloquear todos os bots da OpenAI”, você o remove.
A antiga recomendação de simplesmente bloquear ou permitir “bots de IA” como uma única categoria agora tem mais probabilidade de prejudicar sua visibilidade do que proteger seu conteúdo.
A BrightonSEO reforça isso do ponto de vista diagnóstico. Diferentes rastreadores de IA se comportam de maneira muito diferente quando chegam ao seu site: GPTBot, os rastreadores da Anthropic, o rastreador de Visão Geral de IA do Google e o rastreador da Perplexity priorizam páginas diferentes, exploram em níveis de profundidade diferentes e seguem padrões de frequência distintos.
Entender quais rastreadores estão realmente visitando quais páginas, algo visível apenas nos arquivos de log do seu servidor, revela muito sobre onde seu conteúdo está sendo ou não indexado pela IA.
Um ponto de partida pragmático para o robots.txt em 2027
- Permita os bots de busca padrão (Googlebot, Bingbot) sem exceção, a menos que você tenha um motivo específico para excluir uma seção do site.
- Escolha bots de treinamento (GPTBot, Google-Extended, ClaudeBot, CCBot) de forma consciente, com base na sua própria posição em relação aos dados de treinamento de IA, e não por padrão.
- Permita bots de recuperação e pesquisa (OAI-SearchBot, PerplexityBot e equivalentes) se quiser aparecer em respostas de IA em tempo real, que para a maioria das empresas comerciais é a visibilidade que realmente gera leads.
- Verifique se sua CDN ou firewall está de acordo com seu arquivo robots.txt. Um bloqueio imposto no nível do WAF ou da CDN sobrepõe-se a uma regra permissiva do robots.txt, e a discordância entre as duas camadas é uma causa comum e invisível da invisibilidade da IA.
- Revise, não configure e esqueça. Este cenário mudou rapidamente nos últimos dois anos e continuará mudando. Um arquivo robots.txt revisado em 2024 provavelmente estará incorreto hoje.
No arquivo llms.txt: uma recomendação clara
Você já deve ter visto o llms.txt proposto como uma solução rápida para otimização por IA: um arquivo Markdown, semelhante ao robots.txt, destinado a guiar agentes de IA até o seu melhor conteúdo.
É uma ideia que parece razoável e gerou grande entusiasmo no setor, inclusive da nossa parte. Os dados, porém, não justificam priorizá-lo.
Os testes revelaram que apenas 0,1% do tráfego de bots de IA acessou arquivos llms.txt, sem nenhuma correlação positiva com a melhoria da visibilidade da IA.
Essa descoberta é corroborada por pesquisas independentes: a análise do Search Engine Land sobre o padrão observa que ainda não está claro como os rastreadores de IA usam o arquivo ou qual o impacto dele no treinamento e na indexação, e cita um teste independente realizado por um profissional em dez sites, que constatou que o llms.txt não fez nenhuma diferença mensurável. Ele não é ativamente prejudicial e é barato de implementar na maioria dos CMSs modernos, então não há motivo para evitar adicioná-lo.
Mas se ele estiver entre as principais prioridades da sua lista de SEO técnico, essa é a decisão errada. Dados estruturados, rastreabilidade, consistência de entidades e qualidade do conteúdo são onde as evidências indicam que você deve investir seu tempo.
Principais indicadores vitais da web e experiência da página em 2027
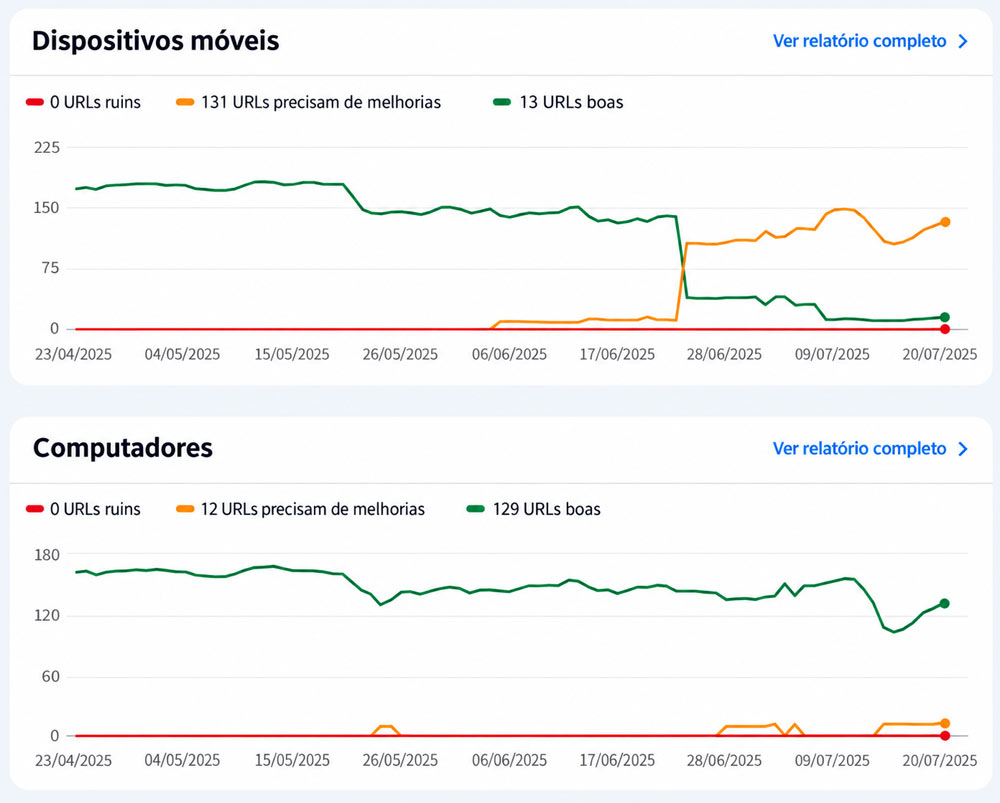
Houve um período, há alguns anos, em que as Core Web Vitals começaram a parecer algo resolvido, notícia velha. Mas não são. Elas são requisitos básicos que tanto os rastreadores tradicionais quanto os de IA utilizam cada vez mais antes de qualquer outra informação sobre o seu site ser avaliada.
As próprias diretrizes atuais do Google, divulgadas pelo Search Central, definem claramente as três métricas e seus limites, e esses números não sofreram alterações:
- Largest Contentful Paint (LCP) – mede o desempenho de carregamento. Critério de avaliação do Google: ocorre nos primeiros 2,5 segundos após o início do carregamento da página.
- Interação para a Próxima Renderização (INP) – mede a capacidade de resposta. A meta do Google é inferior a 200 milissegundos . O INP substituiu o First Input Delay como métrica de capacidade de resposta em março de 2024 e mede a pior latência de interação em toda a sessão, não apenas no primeiro clique.
- Deslocamento cumulativo de layout (CLS) – mede a estabilidade visual. A meta do Google é uma pontuação inferior a 0,1 .
O Google avalia os três com base no 75º percentil de dados reais de visitantes (não dados de laboratório, não um único teste), o que significa que a consistência em todo o seu tráfego real importa mais do que uma única boa pontuação no PageSpeed Insights.
Por que isso agora também está oculto abaixo da sua visibilidade de IA?
É possível traçar uma linha direta entre as Core Web Vitals e o comportamento de rastreamento da IA: os rastreadores de IA despriorizam páginas lentas e tecnicamente inacessíveis de maneira muito semelhante à priorização do orçamento de rastreamento do Google.
Uma página que carrega lentamente, muda de posição durante o carregamento ou demora a responder à interação é uma página na qual os rastreadores de IA passam menos tempo e que, potencialmente, não são indexadas completamente.
Isso cria uma hierarquia clara para qualquer marca que busque tanto classificações tradicionais quanto citações por IA: primeiro, corrija a rastreabilidade e a renderização do JavaScript; em seguida, certifique-se de que as páginas que você mais deseja que sejam citadas estejam tecnicamente em conformidade com os padrões das Core Web Vitals. Todo o resto — dados estruturados, arquitetura de entidades, otimização de conteúdo — se baseia nessa fundação.
O argumento comercial para priorizar isso também não é abstrato. Ou seja: mais rastreamento não significa que você terá uma classificação melhor, mas não ser rastreado significa que você não pode se classificar.
A mesma lógica se aplica perfeitamente à citação por IA: uma página tecnicamente saudável não tem garantia de ser citada, mas uma página que um rastreador de IA tem dificuldade para carregar ou analisar se remove da disputa antes mesmo da qualidade do conteúdo ser avaliada.
Onde conferir seus números
- Google Search Console – o relatório Core Web Vitals, baseado em dados reais de usuários do Chrome (CrUX) em um período contínuo de 28 dias.
- PageSpeed Insights – combina dados de campo com dados de laboratório do Lighthouse e fornece correções específicas e práticas para cada URL.
- Ferramentas de auditoria de terceiros (Semrush, Ahrefs, Screaming Frog) – úteis para monitoramento em todo o site e para sinalizar regressões antes que elas apareçam no Search Console.
Se você não verificou esses indicadores no último trimestre, está navegando às cegas em um dos fundamentos que sustentam tanto seus rankings tradicionais quanto sua visibilidade em relação à IA.
Dados estruturados e marcação de esquema: o sinal que a IA realmente recompensa
Esta é a área técnica onde as evidências são mais consistentemente encorajadoras, pois confirmam que um investimento que recomendamos aos nossos clientes há anos está a gerar retornos que vão muito além dos tradicionais lucros expressivos.
O próprio Google é direto sobre o que os dados estruturados fazem e o que não fazem. Não se trata de um fator de classificação direto, mas, nas palavras do próprio Google, faz parte de como os resultados avançados e a Busca entendem o conteúdo e o contexto de uma página, e os efeitos cumulativos subsequentes — melhor compreensão das entidades, aparência mais rica nos resultados de pesquisa e elegibilidade para citação na Visão Geral de IA — contribuem para um crescimento orgânico significativo ao longo do tempo.
Os testes constataram que os dados estruturados produzem melhorias significativas e mensuráveis na visibilidade do Google, especificamente. Seu efeito direto em outras plataformas de otimização para mecanismos de busca (SEO) é menos certo, mas a cadeia indireta — melhor desempenho no Google levando a mais citações, que por sua vez alimentam os dados de treinamento da IA — faz com que valha a pena implementá-lo, independentemente da plataforma para a qual você esteja otimizando.
Os tipos que valem a pena priorizar
Você não precisa implementar todos os mais de 800 tipos do Schema.org. Priorize:
- Esquema organizacional na sua página inicial, incluindo links sameAs precisos para todos os perfis verificados que sua marca controla (mais detalhes abaixo).
- Esquema de artigo ou postagem de blog nas páginas de conteúdo, para reforçar os dados de autoria e publicação.
- Utilizar os esquemas de Produto, Avaliação e Negócio Local sempre que realmente aplicável, visto que estes possuem o maior peso de citação por IA para consultas comerciais.
- O esquema FAQPage é usado quando uma página realmente responde a perguntas específicas, mas com uma ressalva: o Google reduziu a exibição de resultados avançados de FAQs na busca padrão, então não adicione a marcação FAQ apenas para tentar obter um resultado avançado que pode não aparecer mais. Ainda é possível usar sistemas de resposta baseados em IA quando o conteúdo em si for realmente útil.
Neil Patel coloca os dados estruturados firmemente dentro da disciplina de SEO técnico, juntamente com a velocidade do site, a compatibilidade com dispositivos móveis e as Core Web Vitals, não como um mero extra na página, mas precisamente porque se trata de infraestrutura fundamental e não de um mero aprimoramento de conteúdo.
Arquitetura de entidade: a camada estratégica onde os dados estruturados se encontram.
A marcação de esquema no seu próprio site é necessária, mas não suficiente.
Dados estruturados ricos em entidades em toda a sua presença online, e não apenas no esquema do site, são o sinal técnico mais importante para o desempenho de buscas por IA quando se analisa o panorama completo.
O conceito que cristalizou isso para nossa equipe foi o índice de confiança da entidade: uma maneira informal, porém genuinamente útil, de pensar sobre o quão confiante um modelo de IA está em sua compreensão de quem é a sua marca.
Ele é construído a partir da consistência em todas as plataformas em que sua marca aparece: o mesmo nome comercial, descrição, categoria e informações de contato em seu site, perfil do Google Meu Negócio, LinkedIn, Wikipedia ou Wikidata (se você se qualificar), Trustpilot e diretórios relevantes do setor.
O mecanismo técnico para conectar esses sinais explicitamente é o mapeamento Schema SameAs, uma propriedade que vincula os dados estruturados do seu site diretamente aos seus perfis verificados em todas as plataformas mencionadas. A implementação não é complexa, mas a maioria dos sites de pequeno e médio porte ainda não a utiliza. Agora, ela faz parte do nosso checklist de implementação padrão para todos os clientes.
O texto âncora de marca agora supera consistentemente as âncoras de palavras-chave de correspondência exata em termos de eficácia de links. É a mesma mudança subjacente à arquitetura de entidades: a web está passando do reconhecimento de palavras-chave para o reconhecimento de marcas.
Cada decisão técnica e de construção de links agora precisa reforçar uma entidade de marca consistente, e não apenas visar uma frase.
Após qualquer atualização de conteúdo, valide tudo por meio do Teste de Resultados Avançados do Google e do Validador de Marcação de Esquema, pois erros e avisos podem surgir silenciosamente, principalmente após uma alteração no CMS ou no tema.
Armadilhas da indexação “Mobile-First” e da renderização em JavaScript
Nesta seção, encontram-se dois riscos técnicos distintos, porém relacionados, e as sessões técnicas da BrightonSEO classificaram o segundo como a questão de maior prioridade para qualquer empresa que se preocupe especificamente com a capacidade de descoberta por IA.
Indexação mobile-first: ainda é o padrão, mas ainda é negligenciada.
O Google indexa e classifica seu site com base na versão mobile, não na versão desktop.
A equipe de SEO do conceituado Bruce Clay descreve o cenário atual de forma clara em suas diretrizes estratégicas para 2026: o desempenho técnico e uma arquitetura lógica, com foco em dispositivos móveis, não visam apenas agradar o rastreador; trata-se de criar um ambiente que mantenha os visitantes reais engajados, e essa mesma infraestrutura é o que determina se os resultados baseados em IA conseguem analisar seu conteúdo com facilidade.
Os erros mais comuns em dispositivos móveis que ainda observamos em nossas auditorias mais recentes de clientes:
- Conteúdo oculto atrás de abas ou acordeões que não é totalmente acessível ao rastreador móvel, ou que é renderizado de forma diferente da versão para desktop.
- Interstícios intrusivos que bloqueiam o conteúdo na transição de um resultado de pesquisa móvel para um conteúdo já existente, prática que o Google penaliza há anos e que os rastreadores de IA não conseguem combater de forma mais eficaz.
- Dados estruturados presentes na versão desktop, mas ausentes na versão mobile, uma lacuna surpreendentemente comum quando os sites usam modelos separados.
- Tamanhos de fonte e alvos clicáveis que não atendem aos testes básicos de usabilidade em dispositivos móveis, o que está cada vez mais correlacionado com baixas pontuações nos indicadores Core Web Vitals em tráfego real de dispositivos móveis.
Renderização em JavaScript: a questão de maior prioridade em termos de visibilidade da IA.
Essa é a descoberta que colocaríamos no topo de qualquer lista de prioridades técnicas para 2027, porque vários palestrantes independentes no BrightonSEO convergiram para o mesmo ponto a partir de ângulos diferentes, e o risco está se agravando à medida que mais empresas criam sites usando ferramentas de IA que geram front-ends com uso intensivo de JavaScript por padrão.
Se o seu site depende de JavaScript para renderizar o conteúdo, ou seja, se o texto, os títulos, os produtos ou os preços só aparecem depois que um script é executado no navegador, os rastreadores de IA frequentemente não conseguem lê-lo.
O Google passou uma década resolvendo esse problema para o seu próprio rastreador e ainda assim desaconselha o uso dessa abordagem.
Uma orientação técnica da Screaming Frog sobre o assunto é direta: o Google recomenda o uso de renderização no servidor ou pré-renderização em vez de uma abordagem puramente no lado do cliente, porque o processamento de JavaScript é complexo e nem todos os rastreadores de mecanismos de busca conseguem processá-lo com sucesso ou imediatamente.
Se isso ainda é verdade para o próprio rastreador do Google após uma década de investimentos, é consideravelmente mais verdadeiro para os rastreadores por trás do ChatGPT, Claude e Perplexity.
O diagnóstico é simples: renderize suas páginas principais com o JavaScript desativado no seu navegador. Se o conteúdo desaparecer, é muito provável que um rastreador de IA esteja tendo a mesma experiência. Esse é o ponto de partida para uma conversa sobre a correção do problema entre suas equipes de desenvolvimento e SEO, seja por meio de renderização no servidor, pré-renderização ou uma mudança arquitetônica mais ampla.
Isso surgiu em várias sessões e mesas-redondas, não apenas como um problema técnico, mas como uma vulnerabilidade estratégica. Empresas que migraram para frameworks com uso intensivo de JavaScript nos últimos anos por razões de UX perfeitamente válidas agora têm uma dívida técnica oculta em termos de visibilidade de IA. A auditoria é o primeiro passo, mas a conversa sobre a remediação precisa acontecer entre as equipes de desenvolvimento e SEO, e não isoladamente.
Listas de verificação específicas para cada plataforma: Shopify, WordPress, criações personalizadas
A maioria dos princípios técnicos de SEO são independentes de plataforma, mas cada plataforma principal tem seus próprios padrões de falha recorrentes que valem a pena verificar especificamente.
Shopify
- Estrutura de URL: A arquitetura fixa do Shopify, com /products/ e /collections/, pode criar conteúdo duplicado entre coleções. Use tags canônicas de forma consciente, em vez de confiar nos valores padrão.
- Inchaço de aplicativos: cada aplicativo instalado adiciona JavaScript, e as lojas Shopify são particularmente propensas aos problemas de renderização do lado do cliente abordados na Seção 5. Audite os aplicativos instalados trimestralmente e remova qualquer um que não esteja justificando seu uso.
- Páginas de coleção com pouco conteúdo original além de uma grade de produtos são frequentemente descartadas pelos filtros de qualidade. Adicione conteúdo relevante e útil na parte superior da página.
- Velocidade da página: a sobreposição de temas e aplicativos é o maior fator que prejudica a velocidade no Shopify. Execute uma verificação das Core Web Vitals após cada alteração de tema ou aplicativo importante, não apenas no lançamento.
WordPress
- Excesso de plugins: o equivalente no WordPress ao problema de aplicativos do Shopify. Cada plugin representa um risco potencial em termos de velocidade e segurança; faça auditorias e consolide-os regularmente.
- Configuração de cache: um plugin de cache configurado corretamente é praticamente obrigatório para atender aos limites do LCP em hospedagens compartilhadas ou econômicas.
- Conflitos de plugins de SEO: executar mais de um plugin de SEO (como o Yoast em conjunto com os recursos de SEO integrados de um tema, por exemplo) frequentemente gera marcação de esquema duplicada ou conflitante. Analise os dados estruturados renderizados, não apenas as configurações dos plugins.
- Otimização de imagens: as bibliotecas de mídia do WordPress acumulam imagens grandes e não otimizadas por padrão. Essa é consistentemente uma das melhorias mais rápidas disponíveis na plataforma.
Construções personalizadas
- A estratégia de renderização é a primeira decisão, não uma reflexão tardia: decida entre renderização no servidor, geração estática ou uma abordagem híbrida antes do início do desenvolvimento, levando em consideração tanto a rastreabilidade tradicional quanto a de IA, e não apenas a experiência do usuário.
- O sitemap e o robots.txt são responsabilidades do desenvolvedor, não considerações de marketing posteriores: incorpore-os ao seu processo de implantação para que nunca sejam deixados acidentalmente em uma configuração de teste (uma causa surpreendentemente comum para um site desaparecer completamente das buscas após o lançamento).
- Os dados estruturados devem ser modelados, não codificados manualmente em cada página: incorpore a geração de esquemas em seu CMS ou biblioteca de componentes para que permaneçam consistentes à medida que o site cresce, em vez de se degradarem página por página.
Em todas as três plataformas, aplica-se o mesmo princípio fundamental das Seções 2 a 5: a plataforma não muda o que importa; ela muda onde se esconde o risco de errar.
Seu Plano de Ação de SEO Técnico de 90 Dias
Você não precisa corrigir tudo simultaneamente. Aqui está a ordem de prioridade que utilizamos para os nossos clientes, reunindo as recomendações mais consistentes e as orientações mais amplas do setor abordadas neste post.
Dias 1 a 14: Diagnóstico
- Execute o teste de renderização de JavaScript nas suas páginas principais (desative o JavaScript e veja o que continua a acontecer).
- Analise seu arquivo robots.txt em relação à estrutura de rastreamento por rastreador descrita na Seção 2 e verifique se as configurações de sua CDN ou firewall estão de acordo com ela.
- Gere seu relatório de Core Web Vitals no Google Search Console e sinalize as páginas classificadas como “ruins” ou “precisam de melhorias”.
Dias 15 a 40: Conserte a fundação
- Corrija quaisquer falhas de renderização em JavaScript identificadas no diagnóstico, priorizando primeiro as suas páginas comerciais de maior valor.
- Corrija as falhas nos principais indicadores vitais da web, começando pelo LCP (Local Content Page) nas suas páginas de destino com maior tráfego.
- Execute seus dados estruturados no Teste de Resultados Avançados do Google e no Validador de Marcação de Esquema e corrija quaisquer erros ou avisos.
Dias 41 a 65: Construa as camadas superiores
- Implemente o esquema de organização com mapeamento “sameAs” completo em todos os seus perfis verificados.
- Realize uma auditoria de consistência da entidade: verifique o nome da sua marca, a descrição e os dados da categoria no seu Perfil Comercial do Google, no LinkedIn, em diretórios importantes e em perfis de redes sociais e corrija quaisquer inconsistências.
- Execute a lista de verificação específica da plataforma relevante da Seção 6 em seu próprio site.
Dias 66 a 90: Monitore e sistematize
- Configure verificações recorrentes das Core Web Vitals e do monitoramento de erros de rastreamento, em vez de verificações pontuais.
- Se você tiver acesso aos arquivos de log do servidor, execute uma análise básica desses arquivos para verificar quais rastreadores de IA estão realmente visitando seu site e quais páginas eles priorizam.
- Documente todo o processo para que a próxima atualização do site, mudança de tema ou migração não desfaça o trabalho silenciosamente.
Tenha uma visão clara de onde você realmente está
Tudo neste post se desenvolve na mesma ordem em que foi escrito: primeiro, rastreabilidade e indexabilidade; depois, Core Web Vitals; em seguida, dados estruturados e sinais de entidade; e, por fim, o aprimoramento específico da plataforma. Ignorar a marcação de esquema enquanto seu JavaScript oculta silenciosamente seu conteúdo dos rastreadores de IA é esforço gasto na camada errada.
Solicite uma avaliação gratuita de nossos Serviços de SEO em Salvador para ver exatamente como seu site se encontra em relação a esta lista de verificação. Realizaremos uma análise diagnóstica inicial do seu site e, em seguida, discutiremos um diagnóstico completo, conforme descrito neste post, comparando seu site com os Core Web Vitals e os padrões de rastreabilidade relevantes para 2027. Além disso, forneceremos um plano de ação priorizado de 90 dias, e não apenas uma lista de erros.
Agora que você já tem dicas sobre SEO técnico para 2027, leia outros posts em nosso Blog de SEO.